PromptMule
Servicio de caché en la nube para aplicaciones de IA generativaPrompts cacheados, analíticas detalladas y recuperación más rápida
Aspectos destacados
Qué puedes hacer con ella
- Reducir latencia cacheando los prompts más usados
- Auditar el comportamiento de la IA con analíticas
- Optimizar costes evitando recomputar respuestas
Cómo usarla
- 1 Registra tu aplicación en el servicio
- 2 Configura qué prompts se almacenan en caché
- 3 Integra la recuperación de caché y sigue las analíticas
Para quién es
Ventajas
- Plan básico gratuito para empezar
- Transparencia con analíticas y trazabilidad
- Menos latencia en prompts repetidos
Limitaciones
- La caché solo aporta valor si tu app repite prompts similares
- Depende de infraestructura externa como AWS, con su coste y disponibilidad
- Al ser un producto joven, los planes y condiciones pueden cambiar
Qué es PromptMule
PromptMule es un servicio de caché de IA diseñado para aportar confianza, trazabilidad y transparencia en el desarrollo y la operación de aplicaciones de inteligencia artificial generativa. Su mecánica es sencilla de entender: cuando tu aplicación usa prompts con frecuencia, o accede recientemente a ellos, PromptMule los almacena en caché en la nube, de modo que las respuestas se recuperan más rápido que consultando bases de datos tradicionales, reduciendo latencia y coste. El servicio se apoya en tecnologías modernas, incluida la nube de AWS, para garantizar rendimiento, tiempo de actividad y eficiencia. Más allá de la caché, su valor diferencial está en las analíticas detalladas y la trazabilidad: los desarrolladores pueden comprender y monitorizar con claridad el comportamiento y las decisiones de la IA, algo clave cuando se busca transparencia en sistemas generativos. En cuanto al precio, ofrece una variedad de planes, desde un plan básico gratuito hasta planes premium con características adicionales, almacenamiento y capacidad.
Qué puedes hacer con él
- Cachear los prompts más frecuentes de tu aplicación para acelerar respuestas.
- Analizar el comportamiento de tu IA con métricas detalladas.
- Reducir costes evitando recomputar respuestas idénticas o muy similares.
- Empezar con el plan gratuito y escalar a planes premium.
Para quién es
- Desarrolladores que construyen apps con IA generativa y sufren latencias.
- Equipos que necesitan auditar qué prompts entran y qué respuestas salen.
- Startups que quieren optimizar el coste por consulta de sus productos de IA.
Qué tener en cuenta
La caché solo rinde si tu aplicación repite prompts parecidos: si cada consulta es única, el beneficio será limitado, así que analiza primero tus patrones de uso. Tener respuestas en caché implica también gestionar su frescura: si el modelo o el contexto cambian, las respuestas guardadas pueden quedar obsoletas, y necesitarás una política de invalidación. El servicio depende de infraestructura externa, en este caso la nube de AWS, lo que añade una dependencia más a tu pila y un punto a vigilar en cuanto a disponibilidad y coste. Al ser un producto de etapa temprana, sus planes, límites y condiciones pueden cambiar, e incluso la disponibilidad del sitio conviene verificarla antes de comprometerse; consulta siempre la información oficial vigente y prueba el plan gratuito midiendo el impacto real en latencia y coste de tu aplicación antes de escalar.
Preguntas frecuentes
¿Qué gana mi aplicación con la caché?
Respuestas más rápidas a prompts frecuentes que consultando de nuevo.
¿Hay plan gratuito?
Sí, hay plan básico gratuito y planes premium.
¿Qué tecnologías usa?
Tecnologías modernas, incluida la nube de AWS.
Por qué es gratis
Lo que dice la página oficial: Gratis
Los límites gratuitos, la duración de la prueba y las funciones los decide el sitio oficial y pueden cambiar en cualquier momento.
Captura de pantalla
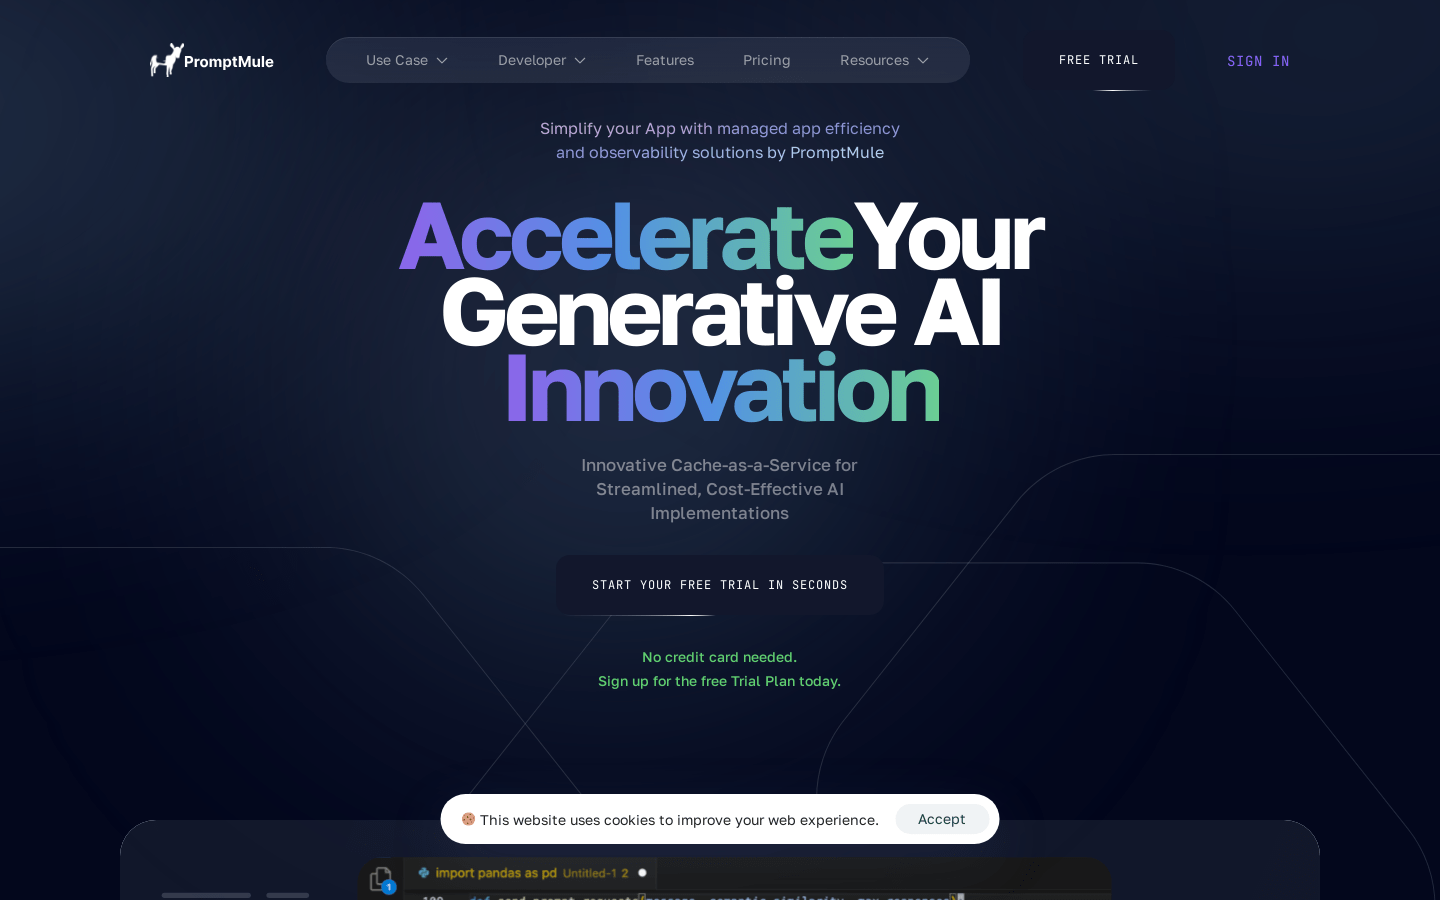
Captura archivada desde la página del listado, solo como referencia.