Aspectos destacados
Qué puedes hacer con ella
- Programadores con agentes de código que quieren respuesta rápida.
- Científicos de datos que cargan varios modelos a la vez.
- Desarrolladores que integran clientes compatibles con OpenAI.
Cómo usarla
- 1 Descarga el DMG o instala desde el código fuente.
- 2 Deja que oMLX lea tu caché de Hugging Face o LM Studio.
- 3 Abre la pantalla de bienvenida y define la carpeta de modelos.
- 4 Configura la API con el generador de comandos del panel.
- 5 Conecta un cliente compatible con OpenAI en localhost:8000.
Para quién es
Ventajas
- Reduce notablemente el tiempo de espera inicial en agentes.
- No depende de la nube para inferir, todo ocurre en el Mac.
- Se integra con herramientas habituales mediante APIs compatibles.
Limitaciones
- Está limitado a macOS con Apple Silicon.
- Requiere cierta configuración técnica para ponerlo en marcha.
- La información de precios no es clara y se presume gratuidad.
Qué es oMLX
oMLX es un servidor de inferencia nativo para macOS diseñado específicamente para Macs con Apple Silicon y construido sobre la base de MLX. Su objetivo es mejorar el rendimiento de la inteligencia artificial en local, especialmente en escenarios de agentes de programación donde la latencia inicial importa mucho. Su tecnología central es un caché KV en SSD paginado con arquitectura de dos niveles: los bloques calientes se mantienen en memoria y los fríos se guardan en disco según una política LRU, de forma que los prefijos ya vistos se recuperan al reiniciar sin necesidad de recalcular. Según la descripción, esto baja el tiempo de respuesta por primera vez de los agentes de un rango de 30 a 90 segundos a menos de 5 segundos. También incorpora procesamiento por lotes continuo, que acelera el manejo de peticiones concurrentes hasta 4,14 veces con concurrencia de 8. Es una aplicación nativa de barra de menús, firmada y notarizada, sin Electron, e incluye un panel web para gestionar modelos, chatear y ver métricas. Admite cargar a la vez LLM, VLM, modelos de embeddings y rerankers, y ofrece APIs compatibles con OpenAI y Anthropic. Utiliza licencia Apache 2.0 y la información disponible no menciona precios, por lo que se presume gratuidad.
Qué puedes hacer con él
- Servir modelos de lenguaje en local desde la barra de menús del Mac.
- Reducir el tiempo de espera inicial de agentes de código con el caché en SSD.
- Cargar varios tipos de modelo a la vez y cambiar entre ellos.
- Conectar clientes compatibles con OpenAI o Anthropic sin cambiar de herramienta.
Para quién es
- Programadores que usan agentes de código en Mac y notan las esperas.
- Científicos de datos que quieren experimentar con varios modelos en local.
- Desarrolladores de IA que necesitan integrar clientes y herramientas existentes.
Qué tener en cuenta
oMLX está limitado a macOS con Apple Silicon, por lo que no sirve en Windows ni en Linux, y su rendimiento depende de la memoria y del disco del equipo. La instalación desde código fuente requiere Python 3.10 y un Mac con Apple Silicon, y la puesta en marcha tiene una curva de aprendizaje técnica que no conviene subestimar. La información disponible sobre precios no es clara y se presume gratuidad, pero conviene revisar las condiciones reales antes de usarlo en un entorno profesional. Además, al ser un proyecto que depende del ecosistema MLX y de Hugging Face, la compatibilidad con modelos nuevos puede tardar en llegar, y algunas funciones pueden cambiar entre versiones.
Preguntas frecuentes
¿oMLX es gratis?
Usa licencia Apache 2.0 y la información disponible no menciona precios.
¿Funciona en Windows o Linux?
No, está diseñado solo para Macs con Apple Silicon.
¿Con qué herramientas se integra?
Ofrece APIs compatibles con OpenAI y Anthropic, y se menciona Claude Code y Cursor.
Por qué es gratis
Lo que dice la página oficial: Uso gratuitoGratis
Los límites gratuitos, la duración de la prueba y las funciones los decide el sitio oficial y pueden cambiar en cualquier momento.
Captura de pantalla
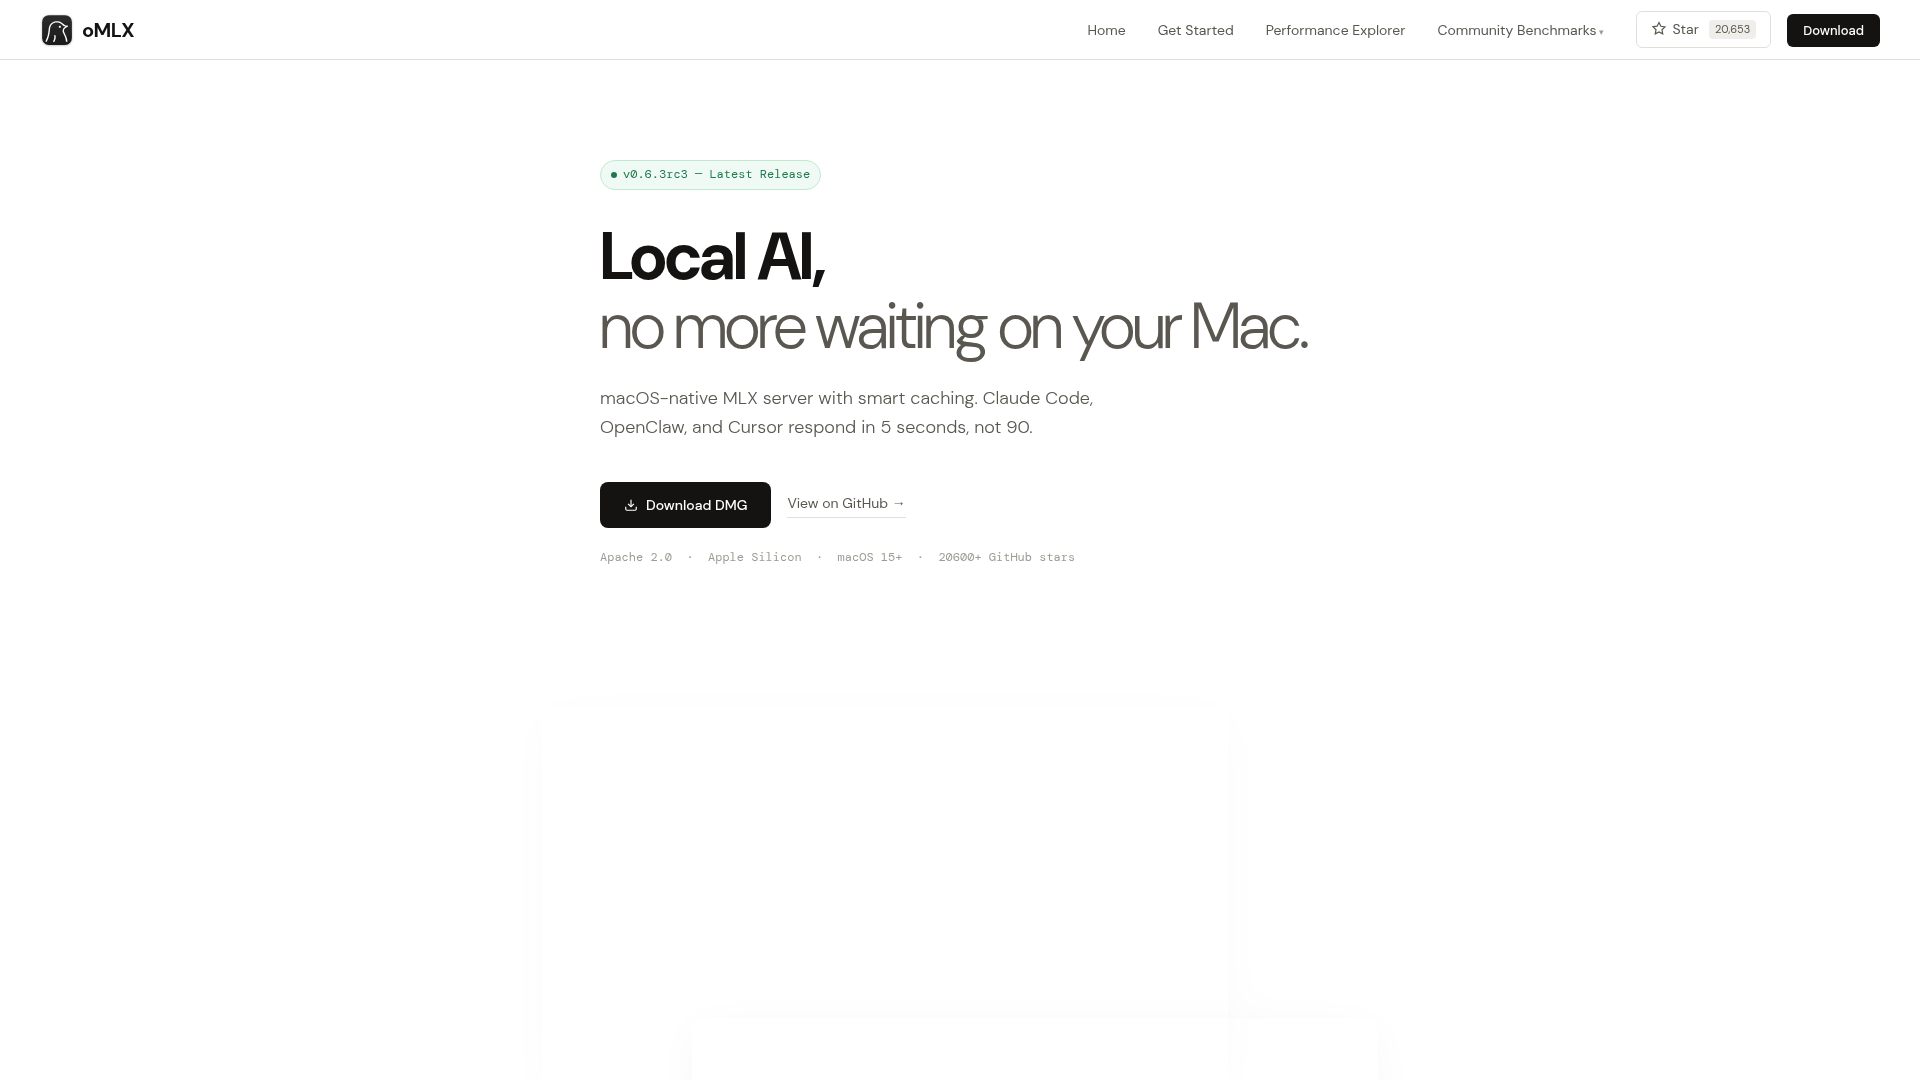
Captura archivada desde la página del listado, solo como referencia.