l1m
API proxy para extraer datos estructuradosExtrae datos estructurados de texto e imágenes
Aspectos destacados
Qué puedes hacer con ella
- Extraer nombres de platos y precios de la foto de un menú
- Extraer años de acontecimientos clave de documentos históricos
- Extraer temperatura y condiciones meteorológicas de un parte del tiempo
Cómo usarla
- 1 Define el JSON Schema con la estructura de datos que quieres extraer.
- 2 Prepara la entrada, que puede ser texto o una imagen en base64.
- 3 Envía la petición a la API con los datos, el Schema y las cabeceras necesarias.
- 4 Configura el tiempo de caché si quieres reducir peticiones repetidas.
- 5 Recibe el JSON estructurado y procésalo en tu aplicación.
Para quién es
Ventajas
- Simplifica la extracción con un enfoque basado en esquemas
- Evita la retención de datos salvo que se active la caché
- Al ser de código abierto se puede autoalojar o usar la versión gestionada
Limitaciones
- La prueba gratuita es limitada y el uso continuado puede requerir pago
- Depende de modelos de terceros, cuyos cambios de API o precios te afectan
- Requiere conocimientos técnicos para definir esquemas e integrar SDK
Qué es l1m
l1m es una herramienta que utiliza grandes modelos de lenguaje a través de un proxy para extraer datos estructurados a partir de texto o imágenes sin estructurar. Su valor está en convertir información compleja en un formato fácilmente procesable, lo que mejora la eficiencia y la precisión del tratamiento de datos. Desarrollado por Inferable, plantea un enfoque Schema-first: defines un JSON Schema con la estructura que necesitas y la herramienta se ocupa del resto, sin ingeniería de prompts compleja ni múltiples llamadas. Admite modelos compatibles con OpenAI o Anthropic, incorpora una función de caché que se activa con la cabecera x-cache-ttl y declara que no retiene datos del usuario salvo cuando se usa esa caché. Es un proyecto de código abierto y ofrece prueba gratuita.
Qué puedes hacer con él
- Extraer datos de texto libre y devolverlos como JSON válido.
- Leer información de imágenes, como menús o documentos escaneados.
- Reducir coste y latencia con la caché integrada.
- Integrarlo en tu propio stack mediante SDK de Node.js, Python o Go.
Para quién es
- Desarrolladores que necesitan estructurar documentos o imágenes.
- Equipos de datos que alimentan sistemas con información no estructurada.
- Empresas que procesan volúmenes altos de texto y quieren automatizar la extracción.
- Proyectos que prefieren software de código abierto para evitar bloqueos de proveedor.
Qué tener en cuenta
La prueba gratuita tiene límites y el uso sostenido puede requerir un plan de pago. Como la herramienta se apoya en modelos de terceros, cualquier cambio en sus API, precios o disponibilidad afecta a tu integración, así que conviene no acoplarse en exceso a un único modelo. Por último, definir esquemas correctos e integrar los SDK exige cierta experiencia técnica, especialmente cuando los documentos de entrada son ruidosos o están mal escaneados.
Preguntas frecuentes
¿Necesito escribir prompts?
No. Basta con describir el contexto como un JSON Schema.
¿Qué modelos admite?
Cualquier modelo compatible con OpenAI o Anthropic.
¿Guarda mis datos?
No retiene datos del usuario salvo que se utilice la función de caché.
Por qué es gratis
Lo que dice la página oficial: prueba gratuita
Los límites gratuitos, la duración de la prueba y las funciones los decide el sitio oficial y pueden cambiar en cualquier momento.
Captura de pantalla
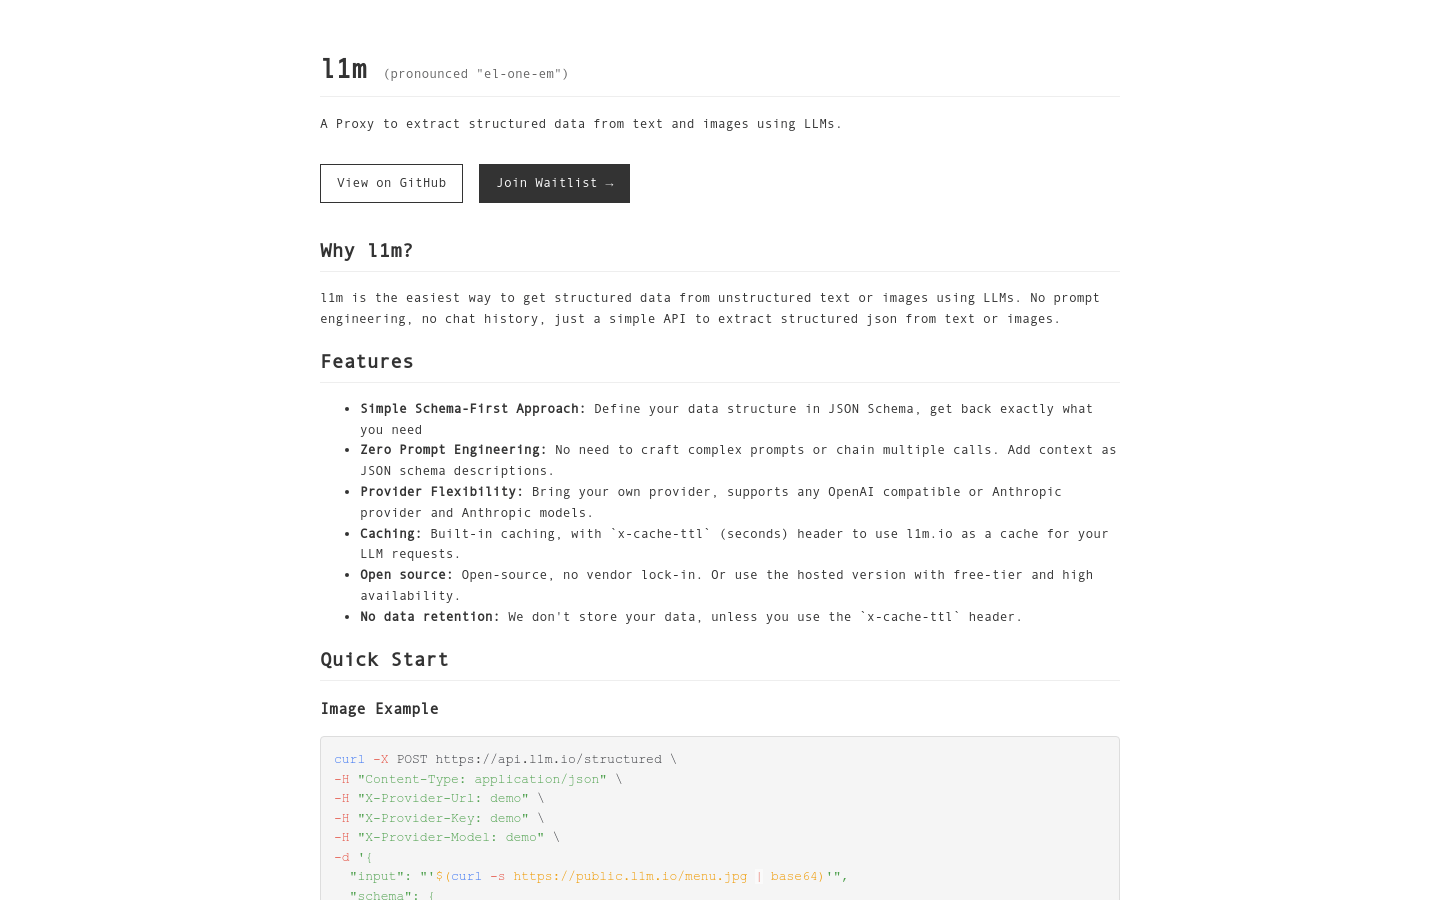
Captura archivada desde la página del listado, solo como referencia.