DaVinci MagiHuman
Modelo open source de video con labios sincronizadosDe una foto y un guion a un video hablado
Aspectos destacados
Qué puedes hacer con ella
- Videos de presentación con voz para creadores de contenido
- Materiales didácticos con un personaje que explica el guion
- Promos de producto con locución sincronizada para marketing
Cómo usarla
- 1 Prepara un retrato frontal claro y un guion o un archivo de audio
- 2 Sube los materiales en la demo en línea o descarga los pesos desde Hugging Face
- 3 Elige la resolución de salida, por ejemplo 256p, 720p o 1080p
- 4 Genera el video y descárgalo al terminar la tarea
- 5 Si lo autoalojas, sigue el README del proyecto y respeta la licencia
Para quién es
Ventajas
- Modelo abierto con pesos disponibles, algo poco habitual en este campo
- Inferencia rápida: un clip de 2 segundos a 256p en torno a dos segundos en una H100
- Experiencia en línea gratuita para probarlo sin instalar nada
Limitaciones
- Generar videos con la foto de otra persona sin su consentimiento puede violar derechos de imagen y normas de plataformas, con consecuencias que recaen en quien publica
- El rendimiento rápido asume GPU de clase H100; en hardware menor los tiempos crecen
- La demo alojada puede tener términos adicionales distintos de la licencia Apache 2.0
Qué es DaVinci MagiHuman
DaVinci MagiHuman es un modelo de IA open source con 15 mil millones de parámetros, publicado por Sand ai junto al laboratorio GAIR de la Universidad Jiao Tong de Shanghai. Bajo licencia Apache 2.0, permite revisar los pesos, realizar inferencia local y llevar a cabo uso comercial dentro del alcance de la licencia. Su función principal es la generación unificada de audio y video: recibe una foto facial y un texto o un audio, y produce un video hablado con los labios sincronizados y el sonido correspondiente, sin necesidad de pasar por un TTS separado ni empalmes. En cuanto a velocidad, puede generar un clip corto de 2 segundos a 256p en aproximadamente dos segundos sobre una única NVIDIA H100. En evaluaciones públicas supera a modelos como Ovi 1.1 y LTX 2.3, con menor tasa de error de palabras y mayor preferencia humana. La experiencia en línea es gratuita.
Qué puedes hacer con él
El flujo de trabajo es directo y cabe en pocos pasos:
- Producir videos de presentador virtual con una sola foto y un guion escrito.
- Crear materiales didácticos donde un personaje explica el contenido con voz sincronizada.
- Generar promos de producto con locución para campañas de marketing.
- Autoalojar el modelo desde Hugging Face si necesitas inferencia local y control total.
Para quién es
- Creadores de contenido que necesitan videos hablados sin rodar.
- Investigadores que trabajan en generación conjunta de audio y video.
- Equipos de marketing que prueban formatos de video con locución.
- Desarrolladores que quieren adaptar un modelo abierto a sus propios productos.
Qué tener en cuenta
Este tipo de tecnología genera videos hablados con el rostro de una persona, así que la responsabilidad de uso es total: úsalo solo con imágenes propias o con autorización explícita del titular, porque crear videos con la cara de otras personas sin permiso puede violar derechos de imagen y las normas de las plataformas, y las consecuencias legales recaen sobre quien publica el contenido. Tampoco se recomienda emplearlo para suplantar identidades o engañar a la audiencia. En lo técnico, los tiempos de generación rápidos se anuncian sobre una H100; con hardware más modesto deberás esperar más o bajar la resolución. Recuerda además que la demo alojada puede aplicar términos adicionales propios, distintos de la licencia Apache 2.0, y que si autoalojas el modelo debes cumplir las condiciones de la licencia.
Preguntas frecuentes
¿Es realmente open source?
Sí. Usa licencia Apache 2.0 y sus pesos pueden revisarse, ejecutarse en local y usarse comercialmente dentro del alcance de la licencia.
¿Qué materiales necesito?
Una foto de retrato y un guion en texto o un archivo de audio, que el modelo alineará con los movimientos de los labios.
¿Puedo usar la cara de cualquier persona?
No. Necesitas autorización del titular de la imagen; usar retratos ajenos sin permiso puede ser ilegal y contra las reglas de las plataformas.
Por qué es gratis
Lo que dice la página oficial: Gratis
Los límites gratuitos, la duración de la prueba y las funciones los decide el sitio oficial y pueden cambiar en cualquier momento.
Captura de pantalla
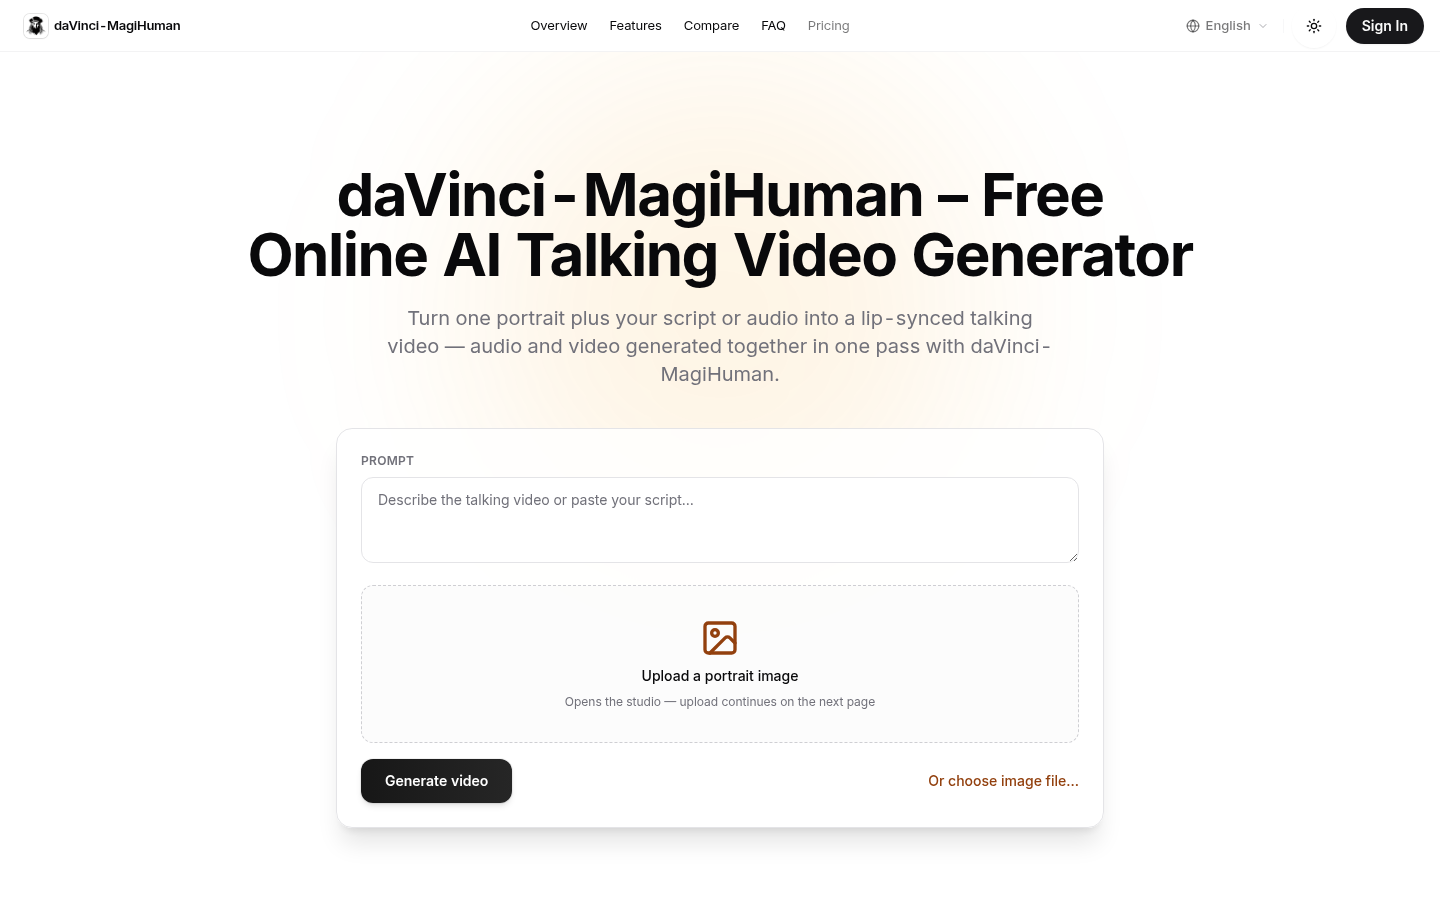
Captura archivada desde la página del listado, solo como referencia.